Redes neuronales: 7 claves imprescindibles para entender el Machine Learning
Qué son las redes neuronales y por qué son esenciales en inteligencia artificial
Las redes neuronales son modelos computacionales capaces de identificar patrones dentro de grandes cantidades de datos. Su diseño se inspira de forma simplificada en la manera en que las neuronas biológicas transmiten información, aunque no intenta reproducir literalmente el cerebro humano. Cada neurona artificial recibe valores, los procesa matemáticamente y envía un resultado a otras unidades conectadas.
Su importancia dentro de la inteligencia artificial radica en que pueden trabajar con información compleja difícil de procesar mediante reglas programadas manualmente. Imágenes, voz, texto o series temporales contienen relaciones que estos modelos pueden aprender a partir de ejemplos. El National Institute of Standards and Technology (NIST) incluye el aprendizaje automático y el aprendizaje profundo entre las tecnologías clave de la inteligencia artificial.
Gracias a esta capacidad, las redes neuronales se utilizan en visión artificial, reconocimiento de voz, procesamiento del lenguaje natural, sistemas predictivos y detección de anomalías.
Cómo se relacionan las redes neuronales con el Machine Learning
El Machine Learning o aprendizaje automático es una rama de la inteligencia artificial que permite desarrollar sistemas capaces de aprender a partir de datos. En lugar de programar manualmente cada situación, se entrenan algoritmos para detectar patrones y utilizarlos en tareas de clasificación, predicción o recomendación.
Las redes neuronales son una de las técnicas más relevantes del Machine Learning, pero no la única. También existen árboles de decisión, regresiones, máquinas de vectores de soporte, algoritmos de clustering y métodos de ensemble. La elección depende del problema, los datos disponibles, la capacidad de cómputo y el nivel de interpretación requerido.
Estas arquitecturas resultan útiles con información no estructurada, como imágenes, audio o lenguaje, porque pueden aprender características complejas sin definir cada regla de forma manual.
Cuál es la estructura básica de una red neuronal
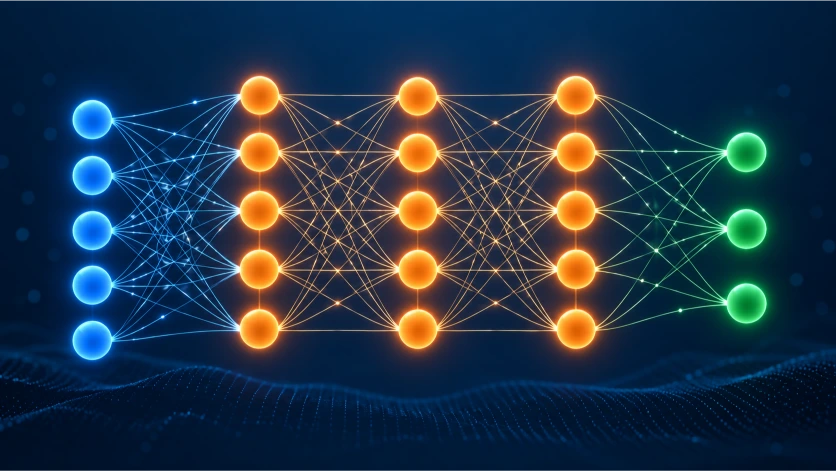
Una red neuronal suele organizarse en tres partes: capa de entrada, capas ocultas y capa de salida. La primera recibe los datos iniciales; las capas ocultas transforman esa información; y la capa final produce el resultado.
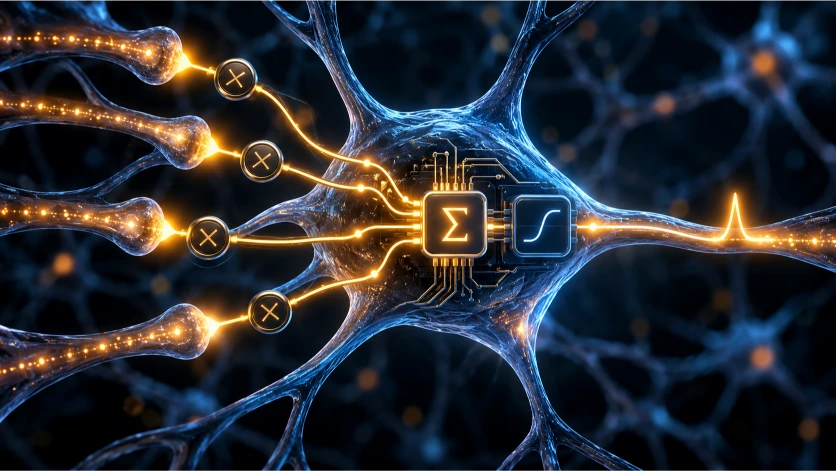
En las capas ocultas, cada neurona recibe valores de la capa anterior, los multiplica por parámetros llamados pesos y añade, en muchos casos, un término denominado bias o sesgo.
Después, aplica una función matemática y transmite el resultado. La capa de salida adapta su formato al problema: puede devolver una categoría, una probabilidad o un valor numérico. La documentación de scikit-learn explica esta estructura mediante el perceptrón multicapa, uno de los modelos básicos para comprender las redes neuronales supervisadas.
Cómo funcionan las neuronas artificiales
La neurona artificial es la unidad básica de estas arquitecturas. Recibe varios valores, multiplica cada uno por un peso y combina los resultados. A esta suma se añade normalmente un valor de sesgo y, después, se aplica una función de activación. La función de activación introduce no linealidad. Gracias a ella, las redes neuronales pueden aprender relaciones mucho más complejas que una simple combinación lineal de variables.
Durante el entrenamiento, los pesos cambian continuamente. Si una conexión resulta útil para mejorar la predicción, su importancia puede aumentar; si aporta poco, puede reducirse.
Al repetirse este proceso en miles o millones de conexiones, el modelo construye representaciones progresivamente más sofisticadas.En visión artificial, por ejemplo, las primeras capas pueden detectar bordes, mientras que las siguientes combinan esa información para reconocer formas u objetos.
Cómo aprenden las redes neuronales durante el entrenamiento
El aprendizaje se produce mediante un proceso iterativo llamado entrenamiento. El objetivo es encontrar los parámetros que permitan al modelo reducir el error de sus predicciones. Primero, el sistema recibe datos de entrenamiento y genera una respuesta. En aprendizaje supervisado, esa respuesta se compara con el valor correcto mediante una función de pérdida, que cuantifica el error. Después, un algoritmo de optimización modifica los pesos para reducir esa
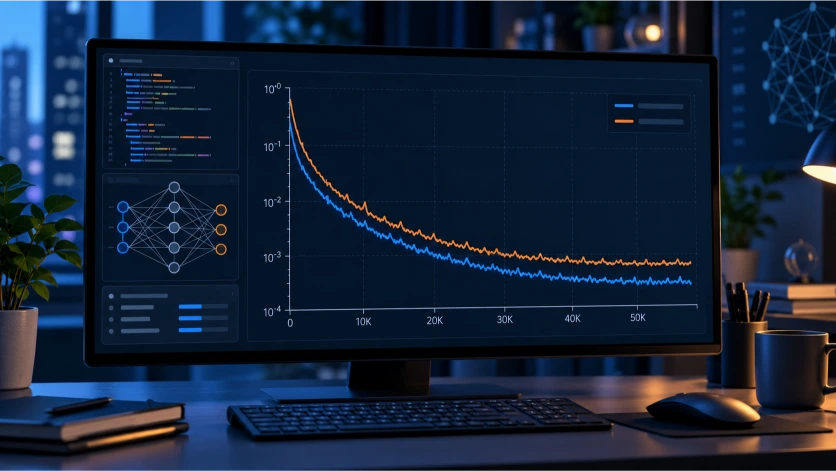
pérdida. El procedimiento se repite numerosas veces hasta que el modelo alcanza un rendimiento adecuado.
Para evaluar el aprendizaje, los datos suelen dividirse en conjuntos de entrenamiento, validación y prueba. Así se puede comprobar si el modelo ha aprendido patrones generales o simplemente ha memorizado los ejemplos utilizados.
La calidad de las redes neuronales depende tanto de la arquitectura como de los datos y de la estrategia de entrenamiento.
Qué es la retropropagación o backpropagation
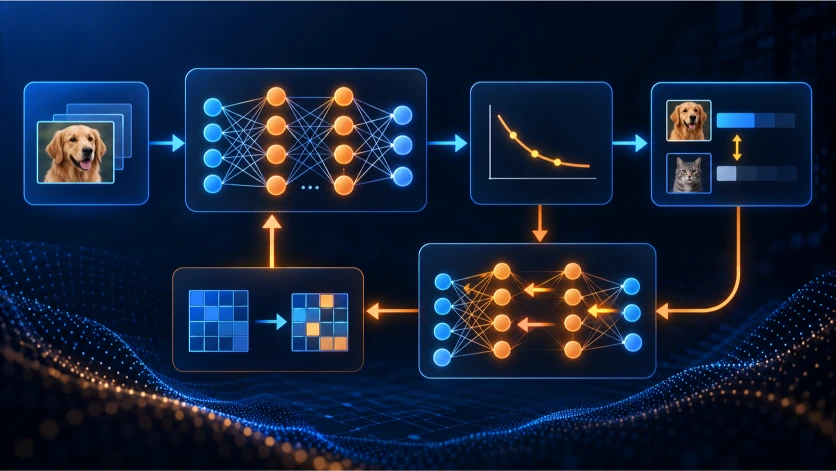
La retropropagación, o backpropagation, es uno de los mecanismos principales para entrenar redes neuronales. Su función es calcular cómo debe modificarse cada parámetro después de que el modelo haya cometido un error.
El proceso comienza con una propagación hacia delante: los datos atraviesan la red desde la entrada hasta la salida y se obtiene una predicción. Después se calcula el error mediante la función de pérdida.
A continuación, el algoritmo recorre matemáticamente la red en sentido inverso y estima cuánto ha contribuido cada peso al error final. Esa información permite ajustar los parámetros en la dirección adecuada.
La documentación de scikit-learn explica que los perceptrones multicapa utilizan backpropagation junto con métodos de optimización basados en gradientes. Este mecanismo hace posible entrenar modelos con muchos parámetros.
Por qué son importantes las funciones de activación
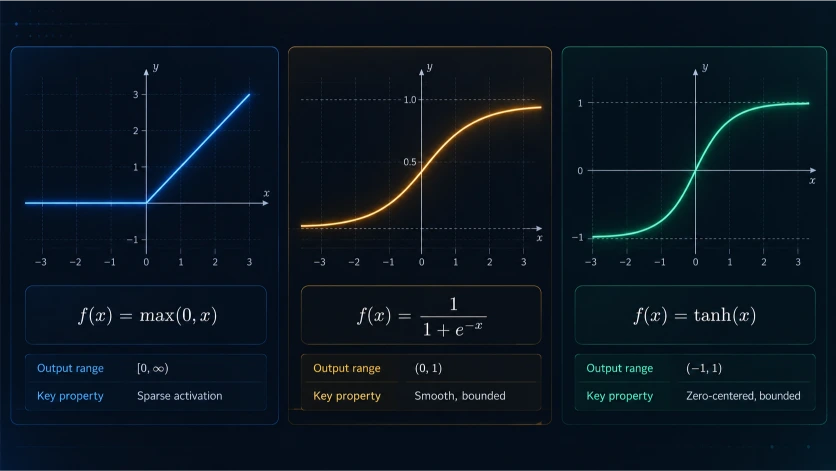
Las funciones de activación permiten que una red neuronal aprenda relaciones no lineales. Sin ellas, incluso una arquitectura con muchas capas tendría una capacidad mucho más limitada.
Entre las más utilizadas se encuentran ReLU, sigmoid y tanh. ReLU es habitual en capas ocultas por su eficiencia. Sigmoid transforma los valores a un rango entre cero y uno, por lo que puede utilizarse en determinadas tareas de clasificación binaria. Tanh genera resultados entre menos uno y uno.
La elección depende del problema y de la posición de la capa. Comprender estas funciones es importante para quienes quieren especializarse en Machine Learning, porque afectan directamente a la capacidad del modelo para aprender, converger y generalizar.
Principales tipos de redes neuronales utilizadas en Machine Learning
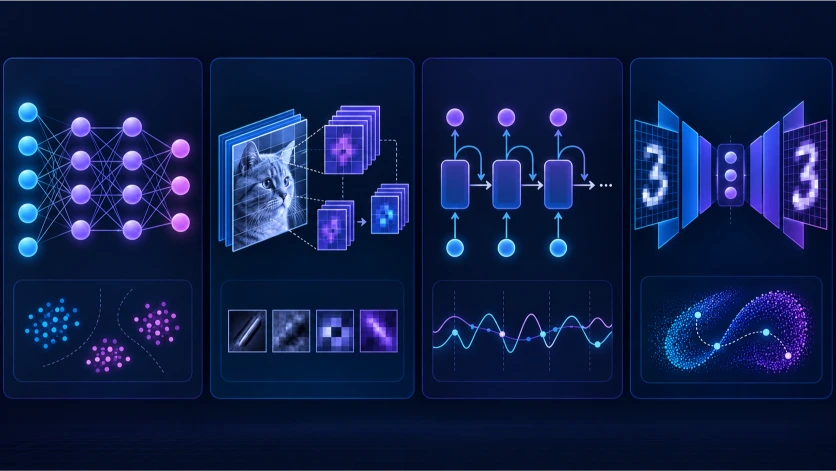
Existen diferentes tipos de redes neuronales porque no todos los problemas requieren la misma arquitectura.
Las redes feedforward o de prealimentación son de las más sencillas: la información avanza desde la entrada hasta la salida sin formar ciclos. El perceptrón multicapa pertenece a esta categoría.
Las redes convolucionales o CNN están diseñadas especialmente para procesar imágenes y datos con estructura espacial. Las redes recurrentes o RNN fueron desarrolladas para trabajar con secuencias y mantener información procedente de pasos anteriores.
También existen arquitecturas residuales, autoencoders y redes generativas. La Organización Internacional de Normalización (ISO) recoge distintas familias utilizadas en inteligencia artificial.
Elegir correctamente el tipo de red depende de la naturaleza de los datos, el objetivo del proyecto y los recursos disponibles.
Qué son las redes neuronales convolucionales o CNN
Las redes neuronales convolucionales, conocidas como CNN, son arquitecturas diseñadas especialmente para analizar imágenes y otros datos organizados espacialmente.
Su funcionamiento se basa en filtros que recorren distintas regiones buscando patrones locales. Durante las primeras capas pueden aprender características simples, como bordes, líneas o texturas. Las capas posteriores combinan esos elementos para reconocer formas y objetos más complejos.
Por ejemplo, una CNN entrenada para reconocer vehículos podría detectar primero contornos y después estructuras asociadas a ruedas o carrocerías hasta determinar si la imagen contiene un automóvil.
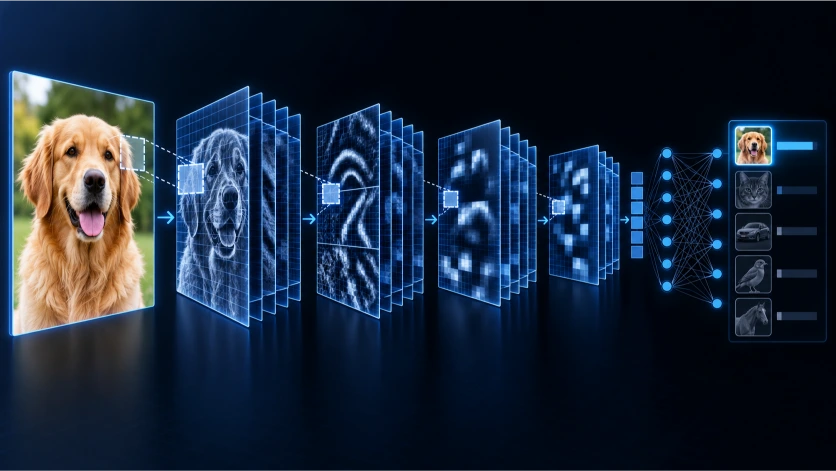
Esta capacidad de aprender características directamente desde los datos transformó la visión artificial, reduciendo la necesidad de diseñar manualmente cada descriptor. Actualmente, las CNN se utilizan en clasificación de imágenes, detección de objetos, análisis industrial, control de calidad, reconocimiento documental y aplicaciones relacionadas con imágenes médicas.
Qué son las redes neuronales recurrentes o RNN
Las redes neuronales recurrentes, conocidas como RNN, fueron diseñadas para procesar información secuencial. A diferencia de una red convencional, pueden mantener parte de la información de pasos anteriores y utilizarla al analizar nuevos elementos.
Esta característica las hizo especialmente útiles en series temporales, reconocimiento de voz y procesamiento del lenguaje natural. En una oración, por ejemplo, una palabra puede depender de información
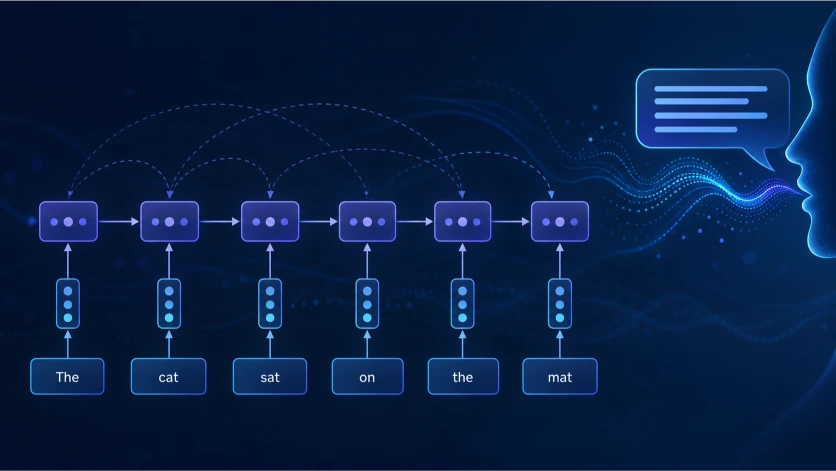
aparecida anteriormente.
Las RNN tradicionales pueden tener dificultades con secuencias largas. Para mejorar este comportamiento surgieron variantes como LSTM y GRU, diseñadas para controlar mejor qué información debe conservarse y cuál puede descartarse. Aunque hoy muchas aplicaciones avanzadas de lenguaje utilizan transformers, estudiar las redes recurrentes sigue siendo útil para comprender la evolución del procesamiento secuencial y determinados sistemas predictivos.
Qué relación existe entre redes neuronales y Deep Learning
El Deep Learning o aprendizaje profundo es una especialización del Machine Learning basada principalmente en redes neuronales con múltiples capas. El término deep hace referencia a la profundidad de estas arquitecturas y a la cantidad de transformaciones que realizan sobre los datos.
Una red sencilla puede contener una o dos capas ocultas, mientras que determinados modelos profundos utilizan muchas más. Esta profundidad permite aprender representaciones jerárquicas: en una imagen, las primeras capas pueden reconocer bordes, las siguientes formas y las posteriores objetos completos.
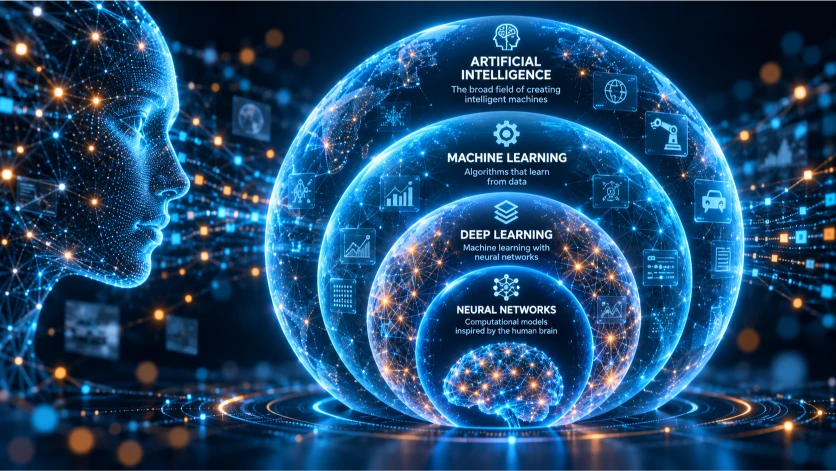
Es importante diferenciar los conceptos. La inteligencia artificial es el campo más amplio; dentro de ella se encuentra el Machine Learning; y dentro de este aparece el Deep Learning, que utiliza principalmente arquitecturas neuronales profundas.
Por tanto, no todo Machine Learning utiliza redes neuronales y no todas las redes necesitan ser profundas. Comprender esta relación es fundamental para avanzar hacia áreas como visión artificial, procesamiento del lenguaje natural y sistemas generativos.
Preguntas frecuentes
📘Másteres relacionados con lo que acabas de leer
Si este contenido te ha ayudado a aclarar ideas, puede que alguno de estos másteres encaje perfectamente con tu perfil. Son programas especializados que te permiten dar un paso más en tu carrera profesional.


💡¿Necesitas ayuda para elegir tu máster?
Un asesor académico puede orientarte según tu experiencia, tus objetivos y el tiempo del que dispones. Podemos atenderte por teléfono o WhatsApp para resolver tus dudas al momento.